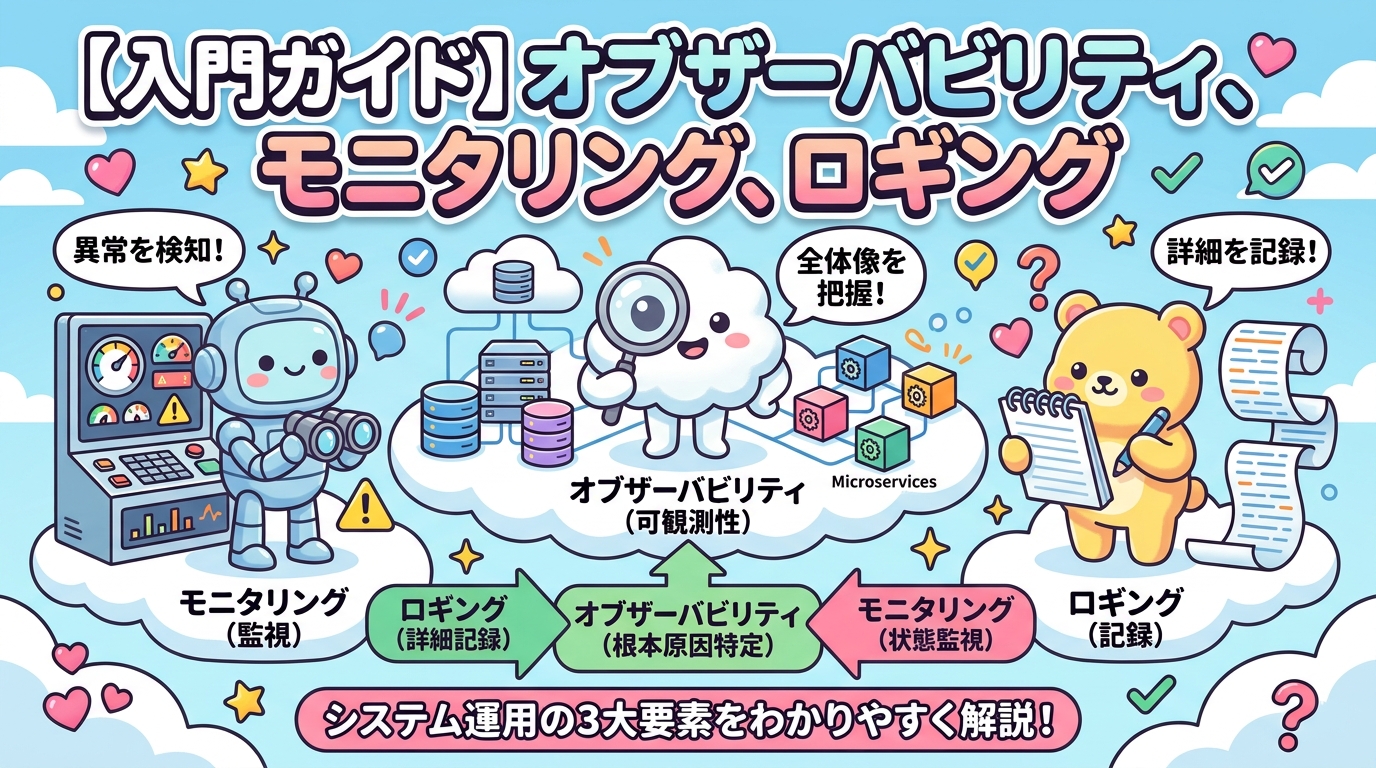
この記事で分かること:監視・ロギング・オブザーバビリティの全体像
本番環境の安定運用に欠かせない「監視」「ロギング」「オブザーバビリティ」は、それぞれ異なる目的と手法を持ちながらも密接に関連しています。本記事では、Datadog・Sentry・ELKスタックなど現場で広く使われているツール群を中心に解説します。本記事では、これら3つの概念の違いを整理した上で、現場で広く使われているDatadog・Sentry・ELKスタックの特徴と選定基準を客観的に解説します。
- 監視(Monitoring):あらかじめ定義した閾値に基づきアラートを発火する、アラート駆動のアプローチ
- ロギング(Logging):アプリケーションが出力するイベントを記録し、障害調査や監査証跡として活用する基盤
- オブザーバビリティ(Observability):メトリクス・ログ・分散トレーシングの三本柱により、システムの内部状態を外部から把握できる状態を目指す考え方
各ツールの立ち位置を簡単に整理すると、Datadogはインフラからアプリケーションまでを統合的に可視化する全方位型プラットフォーム、SentryはエラートラッキングとUI体験に特化した開発者向けツール、ELKスタックはログ収集・検索・可視化をセルフホストで実現するオープンソース基盤です。
本番環境の監視戦略を選定する際の主な判断軸は、チーム規模・スタック構成・予算・運用コストの許容度の4点です。これらを踏まえながら、本記事を通じて自チームに最適な構成を検討してください。
監視・ロギング・オブザーバビリティの基本概念と違い
「監視」「ロギング」「オブザーバビリティ」は同じ文脈で語られることが多いため、混同されがちです。しかし3つは目的と対象が異なります。監視は「何かがおかしい」と気づくための仕組み、ロギングは「何が起きたか」を記録する仕組み、オブザーバビリティは「なぜそうなったか」を調査できる状態を指します。
オブザーバビリティの三本柱として広く知られているのが、メトリクス(Metrics)・ログ(Logs)・トレース(Traces)です。メトリクスは時系列の数値データ、ログはイベントの詳細記録、トレースはリクエストの処理経路を表します。これら3つを組み合わせることで、既知・未知を問わずシステムの内部状態を外部から推測・調査できます。
従来の監視との最大の違いは「未知の問題への対応力」です。従来の監視は既知の失敗パターンに対してアラートを設定するため、想定外の障害には気づきにくい構造があります。オブザーバビリティは豊富な外部出力をもとに「何が起きているかを問い続けられる」状態を目指します。
監視(Monitoring)とは:アラート駆動の従来アプローチ
監視とは、CPUやメモリの使用率、HTTPレスポンスタイム、エラーレートといった指標があらかじめ定義した閾値を超えた際にアラートを発火する仕組みです。Nagios・Zabbix・CloudWatchアラームなどが代表例です。
既知の障害パターン、例えば「ディスク使用率が90%を超えたら通知」「5xxエラーが1分間に10件を超えたら通知」といった定型的な問題には非常に効果的です。一方、これまで発生したことのないパターンの障害や、複数サービス間の複雑な依存関係によって引き起こされる問題には対応しにくいという限界があります。そのため、現代的なシステムでは監視だけで障害対応を完結させることは難しく、ロギングやトレーシングとの組み合わせが前提となります。
ロギング(Logging)とは:イベント記録の基礎
ロギングとは、アプリケーションが処理の過程で出力するイベント記録です。ユーザーのログイン・決済処理の結果・外部API呼び出しの成否など、「何が起きたか」を時系列で残します。ログの種類はアプリケーションログ・アクセスログ・監査ログ・エラーログなどに分類されます。
設計方針として重要なのが、構造化ログ(JSON形式)の採用です。非構造化ログ(プレーンテキスト)は人間には読みやすいものの、検索・集計・アラートへの活用が困難です。JSON形式であれば、ログ収集基盤が自動的にフィールドを解析でき、特定の条件に合致するログだけを高速に絞り込めます。推奨プラクティスとして、timestamp・log_level・service・trace_idなどの標準フィールドを全ログに必ず含めることが挙げられます。
オブザーバビリティ(Observability)とは:システムの内部状態を外部から把握する能力
オブザーバビリティとは、制御理論に由来する概念で「外部出力からシステムの内部状態を推測できる度合い」を指します。ソフトウェア工学では、メトリクス・ログ・分散トレーシングの三本柱を整備することで、本番環境で発生した未知の障害に対しても「コードに手を入れることなく原因を調査できる状態」を実現することを目指します。
分散トレーシングはマイクロサービス環境において特に重要で、1つのリクエストが複数サービスをまたいで処理される際の各ステップを可視化します。OpenTelemetryはこれらのテレメトリデータを標準化して収集するためのオープンソース仕様・SDKとして急速に普及しています。
本番環境における監視・ロギング戦略の設計方針
「とりあえず全部ログに出力する」「アラートを大量に設定する」というアプローチは、コスト肥大化とアラート疲れを招きます。効果的な戦略設計には、何を・どこで・どの粒度で計測するかを意識的に決める必要があります。その軸となるのがSLI・SLO・SLAの枠組みです。
SLI・SLO・SLAの定義と監視設計への組み込み方
SLI(Service Level Indicator)はサービスの品質を表す具体的な指標です。可用性・レイテンシ・エラーレート・スループットなどが代表例です。SLO(Service Level Objective)はそのSLIに対する達成目標値、例えば「月間可用性99.9%以上」や「p95レイテンシ200ms以下」といった具体的な数値目標です。SLA(Service Level Agreement)はSLOをベースにユーザー・顧客と合意した契約上の約束事です。
これらを監視設計に組み込む際に活用するのがエラーバジェットの概念です。SLOを99.9%と設定した場合、月間43.8分の停止が許容されます。このエラーバジェットが消費されるペースを監視することで、機能開発と信頼性改善の優先度を定量的に判断できます。アラートはSLIの絶対値だけでなく、エラーバジェットの消費速度(バーンレート)を基準に設計するとより効果的です。
ログレベル設計とサンプリング戦略
ログレベルの使い分けは、収集コストとデバッグ効率の両立に直結します。一般的な指針は以下のとおりです。
- DEBUG:開発・ステージング環境のみで使用。変数の詳細値など詳細なデバッグ情報
- INFO:正常系の処理フロー。起動完了・ユーザー認証成功など
- WARN:即時対応不要だが注意が必要な事象。リトライ発生・設定値の非推奨利用など
- ERROR:処理が失敗したが継続可能な事象。外部API呼び出し失敗など
- FATAL:アプリケーション継続不可能な致命的エラー
大量トラフィック環境では、INFO・DEBUGレベルのログをすべて保存するとコストが急増します。対策としてヘッドベースサンプリング(リクエスト開始時に一定割合をサンプリング)やテールベースサンプリング(処理完了後にエラーを含むトレースのみ保存)を組み合わせることで、コストを抑えながら障害時の調査に必要な情報を確保できます。
分散トレーシングの導入タイミングと設計
分散トレーシングは、特にマイクロサービスや非同期処理が複数絡む環境で効力を発揮します。「APIは正常だが特定のユーザーだけ遅い」「非同期キュー処理のどこで詰まっているか分からない」といった問題はログ単体では原因特定が困難で、トレーシングが実質必須です。
導入設計の核心はトレースIDの伝播です。HTTPヘッダー(W3C TraceContextやB3形式)を通じて、フロントエンドからバックエンドの各サービス・データベースに至るまで一意のトレースIDを引き継ぎます。OpenTelemetryはこの仕様を標準化したものであり、ベンダーロックインを避けながらDatadog・Jaeger・Grafana Tempoなどの複数バックエンドに対応できるため、新規導入時はOpenTelemetryの活用を推奨します。
主要ツール比較:Datadog・Sentry・ELKスタックの特徴と選定基準
3ツールはカバーする領域が異なるため、単純な優劣比較より「何に使うか」を軸に整理することが重要です。Datadogはオブザーバビリティ全体をカバーするSaaSプラットフォーム、Sentryはエラートラッキングに特化した開発者ツール、ELKはログ基盤をセルフホストで構築するオープンソーススタックです。
Datadog:統合オブザーバビリティプラットフォームの全貌
Datadogの最大の強みは、APM(Application Performance Monitoring)・インフラ監視・ログ管理・RUM(Real User Monitoring)・セキュリティ監視を1つのプラットフォームで統合できる点です。ログからトレース、メトリクスへのシームレスなピボットが可能なため、インシデント調査の効率が高くなります。
エージェントベースの収集アーキテクチャにより、Kubernetes・Docker・AWS・GCPなどの主要環境に対応したインテグレーションが豊富に揃っています。SaaS管理のためインフラ運用コストが削減できる一方、コストが高くなりやすい構造には注意が必要です。特にカスタムメトリクス数・ログの取り込み量・APMホスト数が増えると費用が急増します。費用対効果を最大化するには、不要なメトリクスの収集除外設定とログインデックスの絞り込みが欠かせません。
※本記事執筆時点の情報です。最新の料金体系は公式サイトでご確認ください。
Sentry:エラートラッキングとフロントエンド監視に特化
Sentryは例外・エラーのスタックトレースを自動収集し、発生頻度・影響ユーザー数・初回発生バージョンなどを整理して開発者に通知するエラートラッキングツールです。GitHub・Jira・Slackとの連携が充実しており、エラー検知から修正・デプロイ・解消確認までのフローを一元管理できます。
フロントエンド(JavaScript・React・Vue)からバックエンド(Python・Go・Node.js・Ruby・Java等)まで幅広い言語・フレームワークに対応しています。特にフロントエンドではソースマップを設定することで、ミニファイ済みのJSコードでも元のファイル・行番号まで特定できます。
DatadogとSentryは競合ではなく補完関係にあります。Sentry=エラーの「文脈(誰が・どのバージョンで・どのコードで)」に強く、Datadog=インフラ全体のパフォーマンスと可用性に強い、という役割分担が多くのチームで採用されています。
ELKスタック(Elasticsearch・Logstash・Kibana):自前ログ基盤の構築
ELKスタックは以下の4コンポーネントで構成されます。
- Elasticsearch:ログの全文検索・集計を担うデータストア
- Logstash:ログの収集・変換・転送を担うパイプライン処理エンジン
- Kibana:ダッシュボードと可視化を担うUIフロントエンド
- Beats(FilebeatなどのBeatsファミリー):エッジでの軽量ログ収集エージェント
フルセルフホスト運用の最大のメリットはコストです。クラウドストレージとコンピュートリソースのコストのみでログ基盤を運用でき、SaaSツールと比べてログ量に対する費用は大幅に安くなります。一方で、Elasticsearchのクラスター管理・インデックス設計・シャード調整といったオペレーション負荷は非常に高く、専任の担当者またはそれに準ずる知識が求められます。
この中間的な選択肢としてElastic Cloud(Elasticが提供するマネージドサービス)があり、クラスター管理の手間を省きながらELKの検索性能を活用できます。
※本記事執筆時点の情報です。最新の料金・仕様は公式サイトでご確認ください。
ツール選定マトリクス:チーム規模・用途・予算別の推奨構成
| 規模・フェーズ | 推奨構成 | 主な理由 |
|---|---|---|
| スタートアップ(〜10名) | Sentry + Cloudwatch/Datadog無料枠 | 初期コスト最小・エラー検知を迅速化 |
| 中規模(10〜50名) | Sentry + ELKスタック(or Elastic Cloud) | コスト抑制しつつログ基盤を整備 |
| エンタープライズ(50名〜) | Datadogオールイン or Datadog + Sentry | 統合可視化・SLA管理・サポート体制 |
| コスト重視・技術力高いチーム | ELK + Sentry + Prometheus/Grafana | ほぼオープンソースで全領域をカバー |
単独利用か組み合わせかは、チームの維持コスト(運用工数)も含めて判断することが重要です。Datadogオールインは管理画面が1つで済む反面コストが高く、組み合わせ構成は費用を抑えられる反面ツール間の連携設定に工数がかかります。
実践導入ガイド:各ツールのセットアップと基本設定
各ツールの導入に際して共通して重要なのは、エージェントやSDKの設定を本番投入前にステージング環境で十分検証し、ログ量・メトリクス量が想定コスト内に収まるかを確認することです。
Datadogエージェント導入とAPM・ログ収集の設定
KubernetesへのDatadogエージェントデプロイは、Helm chartを使用するのが最も一般的です。以下は主要な設定項目です。
- APM有効化:datadog.apm.enabled=trueを設定し、各コンテナのDD_AGENT_HOST環境変数をエージェントのServiceに向ける
- ログ収集:datadog.logs.enabled=trueとdatadog.logs.containerCollectAll=trueを有効化し、コンテナのstdout/stderrを自動収集
- ddtraceライブラリ(Python例):pip install ddtraceの後、ddtrace-run python app.py でアプリを起動するだけで自動インストルメンテーションが有効化される
ログパイプラインの設定では、JSON形式のログに対してGrokパーサーやJSONプロセッサーを適用し、timestampフィールドを正しく認識させることが最初の重要ステップです。導入後はService Mapダッシュボードとエラーレート・レイテンシのSLOダッシュボードを最初に確認します。
SentryのSDK統合とアラートルール設定
主要言語へのSDK導入は非常にシンプルです。
- Python:pip install sentry-sdk後、sentry_sdk.init(dsn=”YOUR_DSN”, traces_sample_rate=0.2)をアプリ起動時に実行
- Node.js:npm install @sentry/nodeの後、Sentry.init()をエントリーポイントの先頭で呼び出す
- Go:go get github.com/getsentry/sentry-goの後、sentry.Init()でDSNと環境を設定
アラートルールはイシューアラート(新規エラー発生・エラー頻度急増)とメトリクスアラート(エラーレートが一定閾値超過)を使い分けます。リリース追跡(release属性の設定)とソースマップのアップロードを組み合わせることで、「どのデプロイで発生した何行目のエラーか」を正確に特定でき、原因調査の時間を大幅に短縮できます。
ELKスタックのDocker Compose構築とインデックス設計
ローカル・ステージング環境でのELK構築はDocker Composeが最も手軽です。基本構成はElasticsearch(シングルノード)・Logstash・Kibana・Filebeatの4サービスで立ち上げます。
Filebeatはアプリケーションコンテナのログファイルを監視してLogstashに転送し、LogstashのGrokフィルターでパースした上でElasticsearchに格納します。Kibanaでは最初にインデックスパターン(例:logs-*)を作成し、Discoverでログ検索を確認した後、頻繁に使う絞り込み条件をダッシュボードとして保存します。
インデックス設計の重要なポイントは、1日1インデックスの時系列分割を採用することです。これによりILM(Index Lifecycle Management)との組み合わせで古いデータの自動削除・アーカイブが容易になります。
各ツールの詳細な公式ドキュメントや導入事例を調べる際は、こちらの技術情報まとめサイトも参考になります。
本番運用で陥りがちな落とし穴とベストプラクティス
監視・ロギング基盤を構築した後に多くのチームが直面する課題が、アラート疲れ・コスト爆発・個人情報漏洩リスクの3点です。これらを事前に対策することが、長期的な運用品質の維持につながります。
インシデント発生時の調査ワークフローは、ログ→トレース→メトリクスの順で進めるのが効率的です。まずログでエラーの発生箇所と頻度を絞り込み、次にトレースで処理の流れと遅延箇所を特定し、最後にメトリクスで影響範囲とシステム全体への波及を確認します。
個人情報・機密情報のログ混入は深刻なセキュリティリスクです。パスワード・クレジットカード番号・マイナンバーなどがログに含まれないよう、ログ出力前のマスキング処理をコードレビューチェックリストに組み込み、定期的にログを監査する体制が必要です。
アラート設計:ノイズを減らし本当に重要な通知だけを届ける
アラート疲れとは、過多なアラート通知によってエンジニアがアラートを無視するようになってしまう状態です。防止策として以下のアプローチが有効です。
- アラートはすべてアクションにつながるものだけに絞る。「見るだけで何もしない」アラートは削除する
- PagerDutyなどのオンコールツールと連携し、重大度に応じてP1(即時対応)・P2(翌営業日対応)を分ける
- 閾値は固定値ではなく、過去のトレンドに基づく動的閾値(Anomaly Detection)を活用する
- 同一原因による複数アラートの重複通知を防ぐグルーピング・抑制設定を行う
コストコントロール:ログ量とツール費用の最適化
Datadogでのコスト爆発の主要因は、カスタムメトリクスの増加とログインデックスの肥大化です。対策として、収集するメトリクスの必要性を定期的に棚卸しし、不要なものはDD_DOGSTATSD_NON_LOCAL_TRAFFICやignore_rulesで除外します。ログはすべてインデックスに入れず、エラー・警告レベルのみインデックス化し、それ以外はアーカイブ(S3等)に送ることでコストを数分の1に抑えられます。
ELKではILM(Index Lifecycle Management)を設定し、ホットフェーズ(直近3日)→ウォームフェーズ(30日)→デリートフェーズ(30日以降は自動削除)というライフサイクルを定義することで、ディスク使用量を自動制御できます。
※本記事執筆時点の情報です。各ツールの料金体系・機能は変更される場合があります。最新情報は公式サイトでご確認ください。
まとめ:監視・ロギング・オブザーバビリティ戦略の選び方
本記事で解説した内容を整理します。
概念の再整理:監視はアラート駆動で既知の問題を検知する仕組み、ロギングはイベントを記録する基盤、オブザーバビリティはメトリクス・ログ・トレースの三本柱を通じて未知の問題も調査できる状態を目指す考え方です。3つは互いを補完する関係にあり、いずれか1つで完結するものではありません。
ツールの使い分けポイント:Datadogはインフラからアプリケーションまでの統合可視化が必要なチームに、Sentryはエラートラッキングとコード品質改善を重視するチームに、ELKスタックはログ基盤をコスト効率よくセルフホストしたいチームに向いています。S
おすすめのシステム開発サービス
監視・ロギング・オブザーバビリティの導入は、システム規模や要件に応じて異なります。最適なサービスを選定するには、複数の選択肢を比較検討することが重要です。
発注ナビ — IT製品・システム開発会社の一括比較
発注ナビは、監視ツール導入やシステム開発会社の選定を支援するBtBマッチングサービスです。複数の選択肢から最適なソリューションを見つけることができます。
- 最短1日でIT製品やシステム開発会社が見つかる
- 複数の実装パターンを比較検討できる
- 自社要件に合わせた最適なツール選定が可能